Organisaties vertrouwen steeds meer op AI, maar hebben lang niet altijd zicht op de informatie die hun systemen gebruiken. Wat betekent dat voor de betrouwbaarheid van AI-antwoorden? En hoe houden we zelf de regie over onze data? Een onderzoek van Red Hat en het boek Informatieautonomie van Martijn Aslander zetten aan het denken.
Slechts 38 procent van de ondervraagde Nederlandse CIO’s zegt volledig zicht te hebben op waar bedrijfsdata wordt opgeslagen en verwerkt. Dat las ik in een persbericht van Red Hat van 28 oktober 2026 over onderzoek door Censuswide onder 1.400 CIO’s in veertien landen.
38 procent. Van de… 100.
Nog iets opvallends: 75 procent van diezelfde CIO’s heeft er vertrouwen in dat hun AI-agents veilig en volgens de regels werken. Dat is toch een opmerkelijk verschil. We hebben behoorlijk wat vertrouwen in systemen, terwijl we niet altijd precies weten waar de informatie blijft waarmee ze aan het werk gaan.
Nu betekent dat percentage van 38 procent niet dat de overige deelnemers helemaal niets weten. En vertrouwen in de veiligheid van een systeem is natuurlijk iets anders dan volledig zicht hebben op alle datastromen. Het gaat bovendien om wat CIO’s zelf aangeven, niet om een onafhankelijke controle van hun systemen.
We geven AI steeds meer taken en verantwoordelijkheden, terwijl we niet altijd weten waar de informatie blijft waarmee die AI-systemen werken. Ik heb er niet voor geleerd, maar is dat geen merkwaardige volgorde?
Het antwoord ziet er goed uit
Het verleidelijke van AI is dat je vrijwel meteen iets terugkrijgt. Een antwoord, een voorstel, een analyse, een samenvatting. Als je niet oplet, krijg je een generieke, karakterloze tekst. Keurig geformuleerd, met structuur en vaak ook een duidelijke flow. Het lijkt al meteen op een antwoord dat ‘waar’ is. Je kunt er zo mee aan de slag.
Bij een ouderwetse zoekopdracht was het tenminste duidelijk wanneer je iets niet had gevonden. Je bleef zoeken. Andere zoekterm, andere map, toch maar even een collega vragen. Irritant, maar je wist waar je aan toe was. Niet dat mij dat vaak overkwam; ik had een collega die altijd alles keurig opruimde. Ik kan helaas niet voor de collega in kwestie spreken.
Een AI-toepassing kan ondertussen al een antwoord geven. Dat lijkt handig, maar soms verschuift de vraag ongemerkt. Je vraagt je af of het antwoord goed klinkt, terwijl je eigenlijk wilt weten of de benodigde informatie wel beschikbaar was.
Stel dat je vraagt waarom een klant is afgehaakt. Het systeem vindt clicks en open en offertes. Maar die ene mail waarin de klant uitlegt wat hem dwarszit, staat ergens anders. Makt niet uit: je krijgt toch een verklaring. Misschien zelfs een heel aannemelijke.
Maar dan weet je nog steeds niet of je het hele verhaal hebt.

Dit probleem is ouder dan AI
In juni schreef ik op dit blog over Informatieautonomie van Martijn Aslander. Aanleiding was toen een tikfoutje in een betalingskenmerk en het belastingavontuur dat daarop volgde. Het boek hielp me anders kijken naar organisaties die hun eigen informatie maar moeilijk bij elkaar krijgen. Naar gegevens die ergens bestaan, maar toch niet altijd bruikbaar zijn voor degene die ze ook daadwerkelijk nodig heeft.
Martijn (ik mag Martijn zeggen) richt zich daarbij op iets waar je zelden een enthousiast directieoverleg over zult meemaken: bestandsformaten. Hoe bewaren we informatie? Welke software hebben we nodig om erbij te kunnen? En hoeveel zeggenschap houden we daar zelf over?
Het onderzoek van Red Hat gaat over andere zaken: datastromen, software-afhankelijkheden en de risico’s van externe AI-leveranciers. Maar het raakt wel dezelfde onderliggende kwestie. Hoeveel regie houden we over informatie als die verspreid raakt over systemen, leveranciers en AI-toepassingen?
Eerst even iets terugvinden
Natuurlijk snap ik de aantrekkingskracht van een nieuwe AI-toepassing. Geef mij iets dat werk uit handen neemt en je hebt mijn aandacht. Let’s go. Bakkie erbij en proberen maar. Een middag praten over informatieopslag met Martijn is heel gezellig, weet ik inmiddels. Maar zo klinkt het van tevoren niet.
Als je een AI iets hebt laten zoeken, zou je het ook eens wat vervolgvragen kunnen stellen. Kun je laten zien welke informatie je hebt gebruikt? Wat kon je niet vinden? Waar heb je gezocht? Waar baseer je alles op?
Al moet je natuurlijk ook kunnen controleren of het antwoord op die vragen klopt. Een AI kan immers ook heel overtuigend vertellen waar hij gezocht heeft, zonder dat je zeker weet of dat werkelijk zo is gegaan.
De antwoorden op die vervolgvragen zijn soms minstens zo interessant als die prachtige analyse. Juist omdat het ons dwingt te kijken naar wat er onder het resultaat ligt.
We willen graag dat onze systemen steeds meer weten. Het lijkt me verstandig als we zelf een beetje blijven weten wát ze weten.
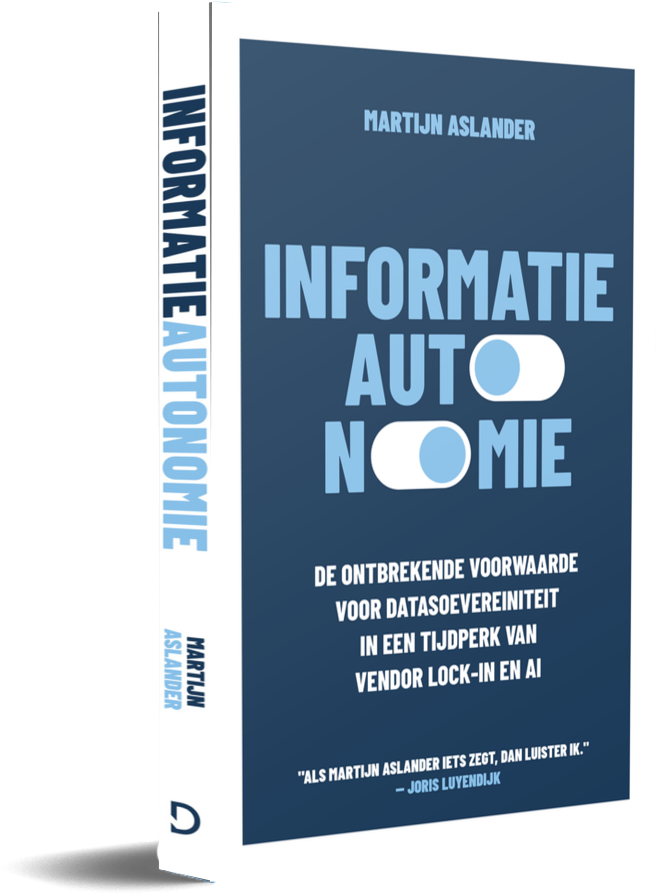
In Informatieautonomie laat Martijn Aslander zien waarom het voor organisaties steeds belangrijker wordt om zelf de regie over hun informatie te houden. Hij legt uit hoe afhankelijk we zijn geworden van software, platforms en bestandsformaten, en waarom dat het delen, terugvinden en gebruiken van informatie onnodig ingewikkeld maakt. Het boek biedt een andere kijk op informatiebeheer en laat zien hoe je informatie toegankelijk, bruikbaar en onder eigen controle houd
Bronnen
- Red Hat (oktober 2026). Onderzoek Red Hat onthult blinde vlekken in de software supply chain van bedrijven. Lees het persbericht op Computable.
- Aslander, Martijn. Informatieautonomie. Van Duuren Media. ISBN 9789463564526. Bekijk het boek
Yoram Vieveen is als marketeer bij uitgeverij Van Duuren Media elke dag de hele dag bezig met lezen wat slimme mensen schrijven, om vervolgens te proberen die boodschap om te zetten in kortere teksten. Hij houdt ervan om zoveel mogelijk (nieuwe) technologie te gebruiken. Yoram is een nerd met een voorliefde voor technologie en fotografie, maar ook over wielrennen kan hij uren praten.
Ontdek meer van Blog van Van Duuren Media
Abonneer je om de nieuwste berichten naar je e-mail te laten verzenden.